Data Products entfalten ihren Wert erst, wenn aus einer Beschreibung ein verlässlich nutzbares Produkt wird. Genau an dieser Stelle positioniert sich Entropy Data. Der Anbieter verbindet Data Contracts, Semantik, einen Data Product Marketplace und Zugriffsprozesse. Neu ist weniger jeder einzelne Baustein als ihr Zusammenspiel und die Idee, den entstehenden Kontext nicht nur Menschen, sondern auch Coding Agents zur Verfügung zu stellen.
Entropy Data ist ein standardbasierter und plattformunabhängiger Data Product Marketplace für Unternehmen, die Data Products bereits als Arbeitsmodell etabliert haben und diese nun für Menschen und AI Agents operationalisieren und skalieren wollen.
Wer ist Entropy Data?
Entropy Data ist ein Spin-off des IT-Beratungsunternehmens INNOQ. Das Produkt ist seit 2023 verfügbar, das eigenständige Unternehmen besteht seit rund einem Jahr. Mit sechs Mitarbeitenden, 13 zahlenden Kunden in acht Ländern (darunter Kuehne+Nagel, GEODIS, DKB) und rund einer Million Euro wiederkehrendem Lizenzumsatz ist Entropy Data klein, nach eigenen Angaben aber profitabel und organisch wachsend.
Die Open-Source-Strategie sorgt für Sichtbarkeit: Die Data Contract CLI hat eine Million Downloads pro Monat. Hinzu kommen mehr als 1.000 GitHub Stars für ODCS und CLI sowie mehrere Tausend Pulls der Community Edition. Das ist noch kein Beleg für breite Enterprise-Adoption, aber ein starkes Signal für das Interesse am Thema.
Was ist das Angebot wirklich?
Entropy Data bezeichnet sich als Data Product Marketplace. Das passt, greift aber weiter als bei Marktplätzen, die Datenprodukte lediglich auflisten. Entropy Data verwaltet Data Products und Contracts, macht sie auffindbar, organisiert Zugriffsanfragen und kann über Events die Berechtigungsvergabe in angeschlossenen Datenplattformen anstoßen.
Das Portfolio im Überblick: Das zentrale Produkt heißt Entropy Data (ehemals Data Mesh Manager und Data Contract Manager) und gliedert sich in drei Funktionsbereiche.
- Der Marketplace unterstützt Discovery, Zugriffsanfragen und Freigaben.
- Im Studio erstellen und verwalten Data Product Owner ihre Data Products und Data Contracts.
- Governance bündelt Policies, Compliance-Prüfungen und Zuständigkeiten.
Darüber hinaus bilden Semantics Geschäftskonzepte, Metriken und Beziehungen als gemeinsame Ontologie ab. Der Data Product Builder stellt Coding Agents den Kontext zur Implementierung neuer Produkte bereit. Ergänzt wird die Plattform durch die eigenständige Open-Source-Komponente Data Contract CLI, die Contracts testet und in Entwicklungs- und CI/CD-Prozesse integriert sowie den Data Contract Editor, um Datenkontrakte zu editieren.
Entropy Data ist in erster Linie für Data Product Owner gebaut: Sie beschreiben, erstellen, veröffentlichen und verantworten die Produkte. Auf der Nutzungsseite adressiert die Plattform zwei Zielgruppen. Menschen sollen Datenprodukte finden, verstehen und anfordern können; AI Agents sollen denselben standardisierten und semantisch angereicherten Kontext maschinell nutzen können. Damit unterstützt die Plattform sowohl Human-Ready Data als auch AI-Ready Data.
Die eigentlichen Daten und Verarbeitungsläufe verbleiben in Systemen wie Snowflake, Databricks oder dbt. Entropy Data bildet darüber einen leichtgewichtigen Metadata- und einheitlichen Zugriffs- und Control-Layer. Die Anwendung kann als SaaS oder selbst gehostet betrieben werden. Das ist besonders für Unternehmen interessant, die mehrere Datenplattformen einsetzen, Metadatensouveränität bewahren und sich nicht vollständig an das proprietäre Modell eines Plattformanbieters binden wollen.
Die wichtigsten Alternativen sind daher weniger klassische Datenkataloge als Databricks, Snowflake und selbst entwickelte Lösungen. Gegenüber diesen Angeboten liegt die stärkste Differenzierung in der konsequenten Unterstützung offener Standards und in der Plattformunabhängigkeit.
Wie funktioniert die Produkterstellung?
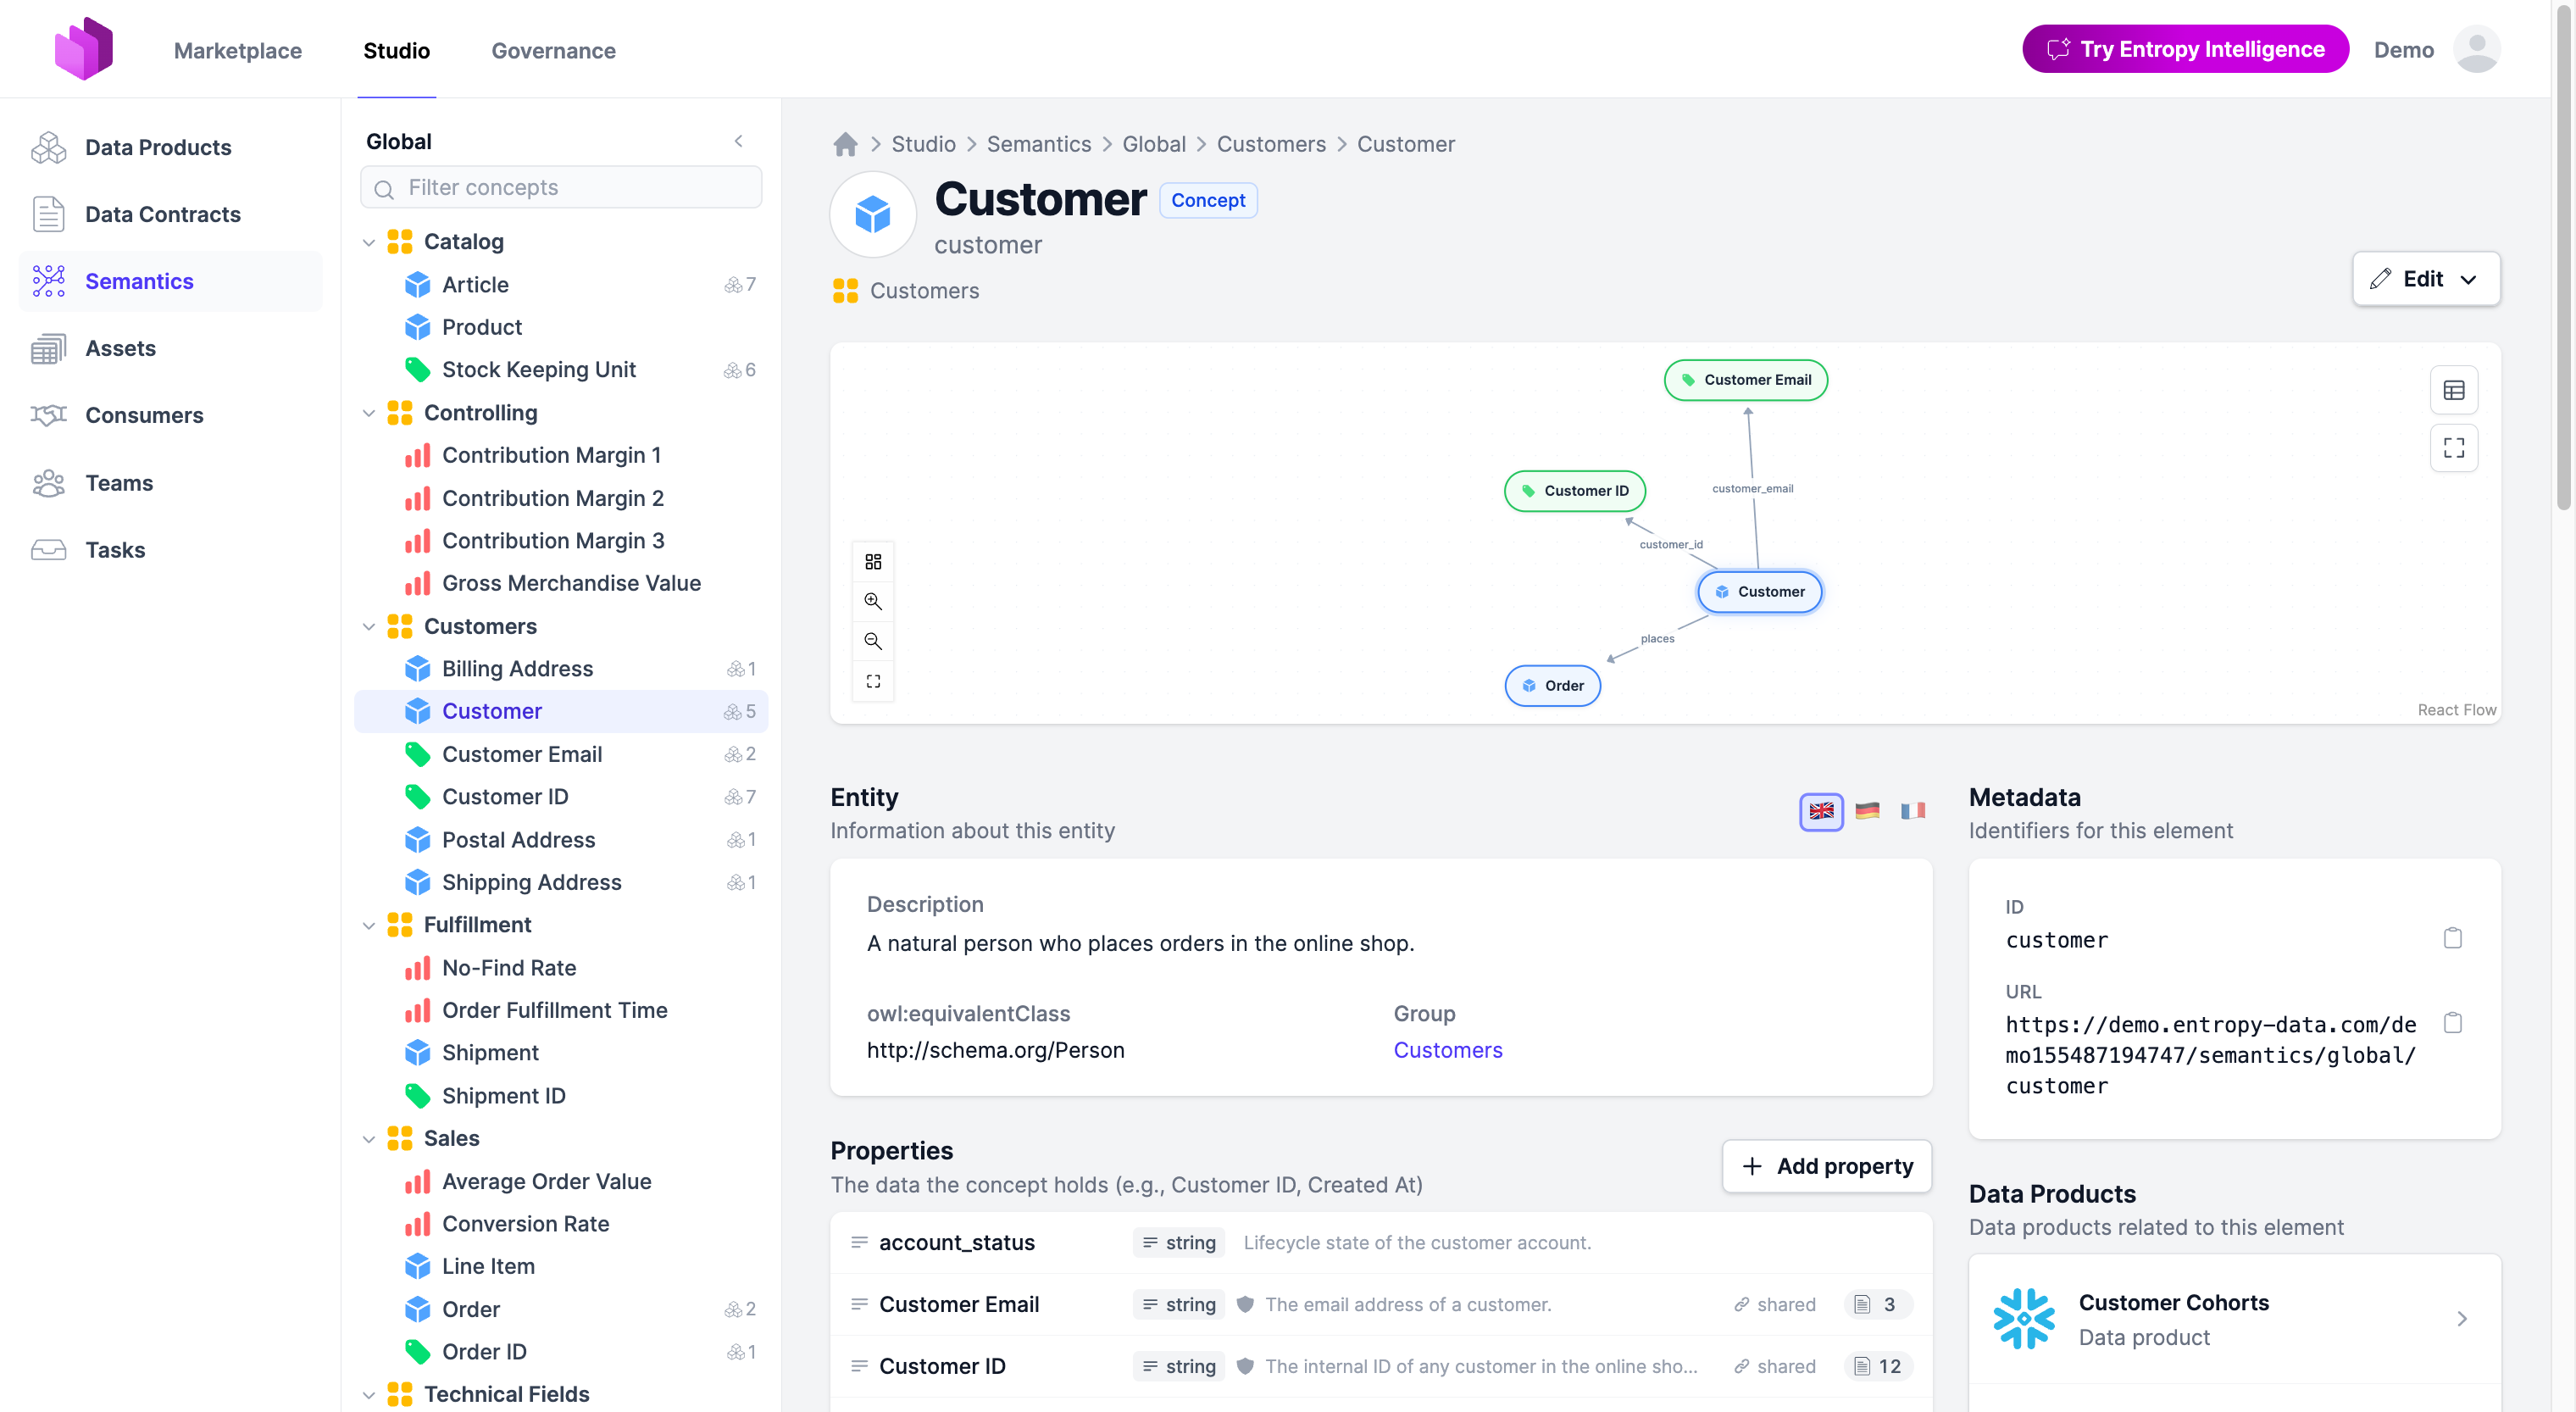
Im Zentrum stehen der Open Data Contract Standard (ODCS) und der Open Data Product Standard (ODPS). ODCS beschreibt unter anderem Schema, Qualität, SLAs und Nutzungsbedingungen; ODPS strukturiert das Datenprodukt. Entropy Data nutzt beide nicht nur als Austauschformat, sondern als Grundlage für Marketplace und Automatisierung.
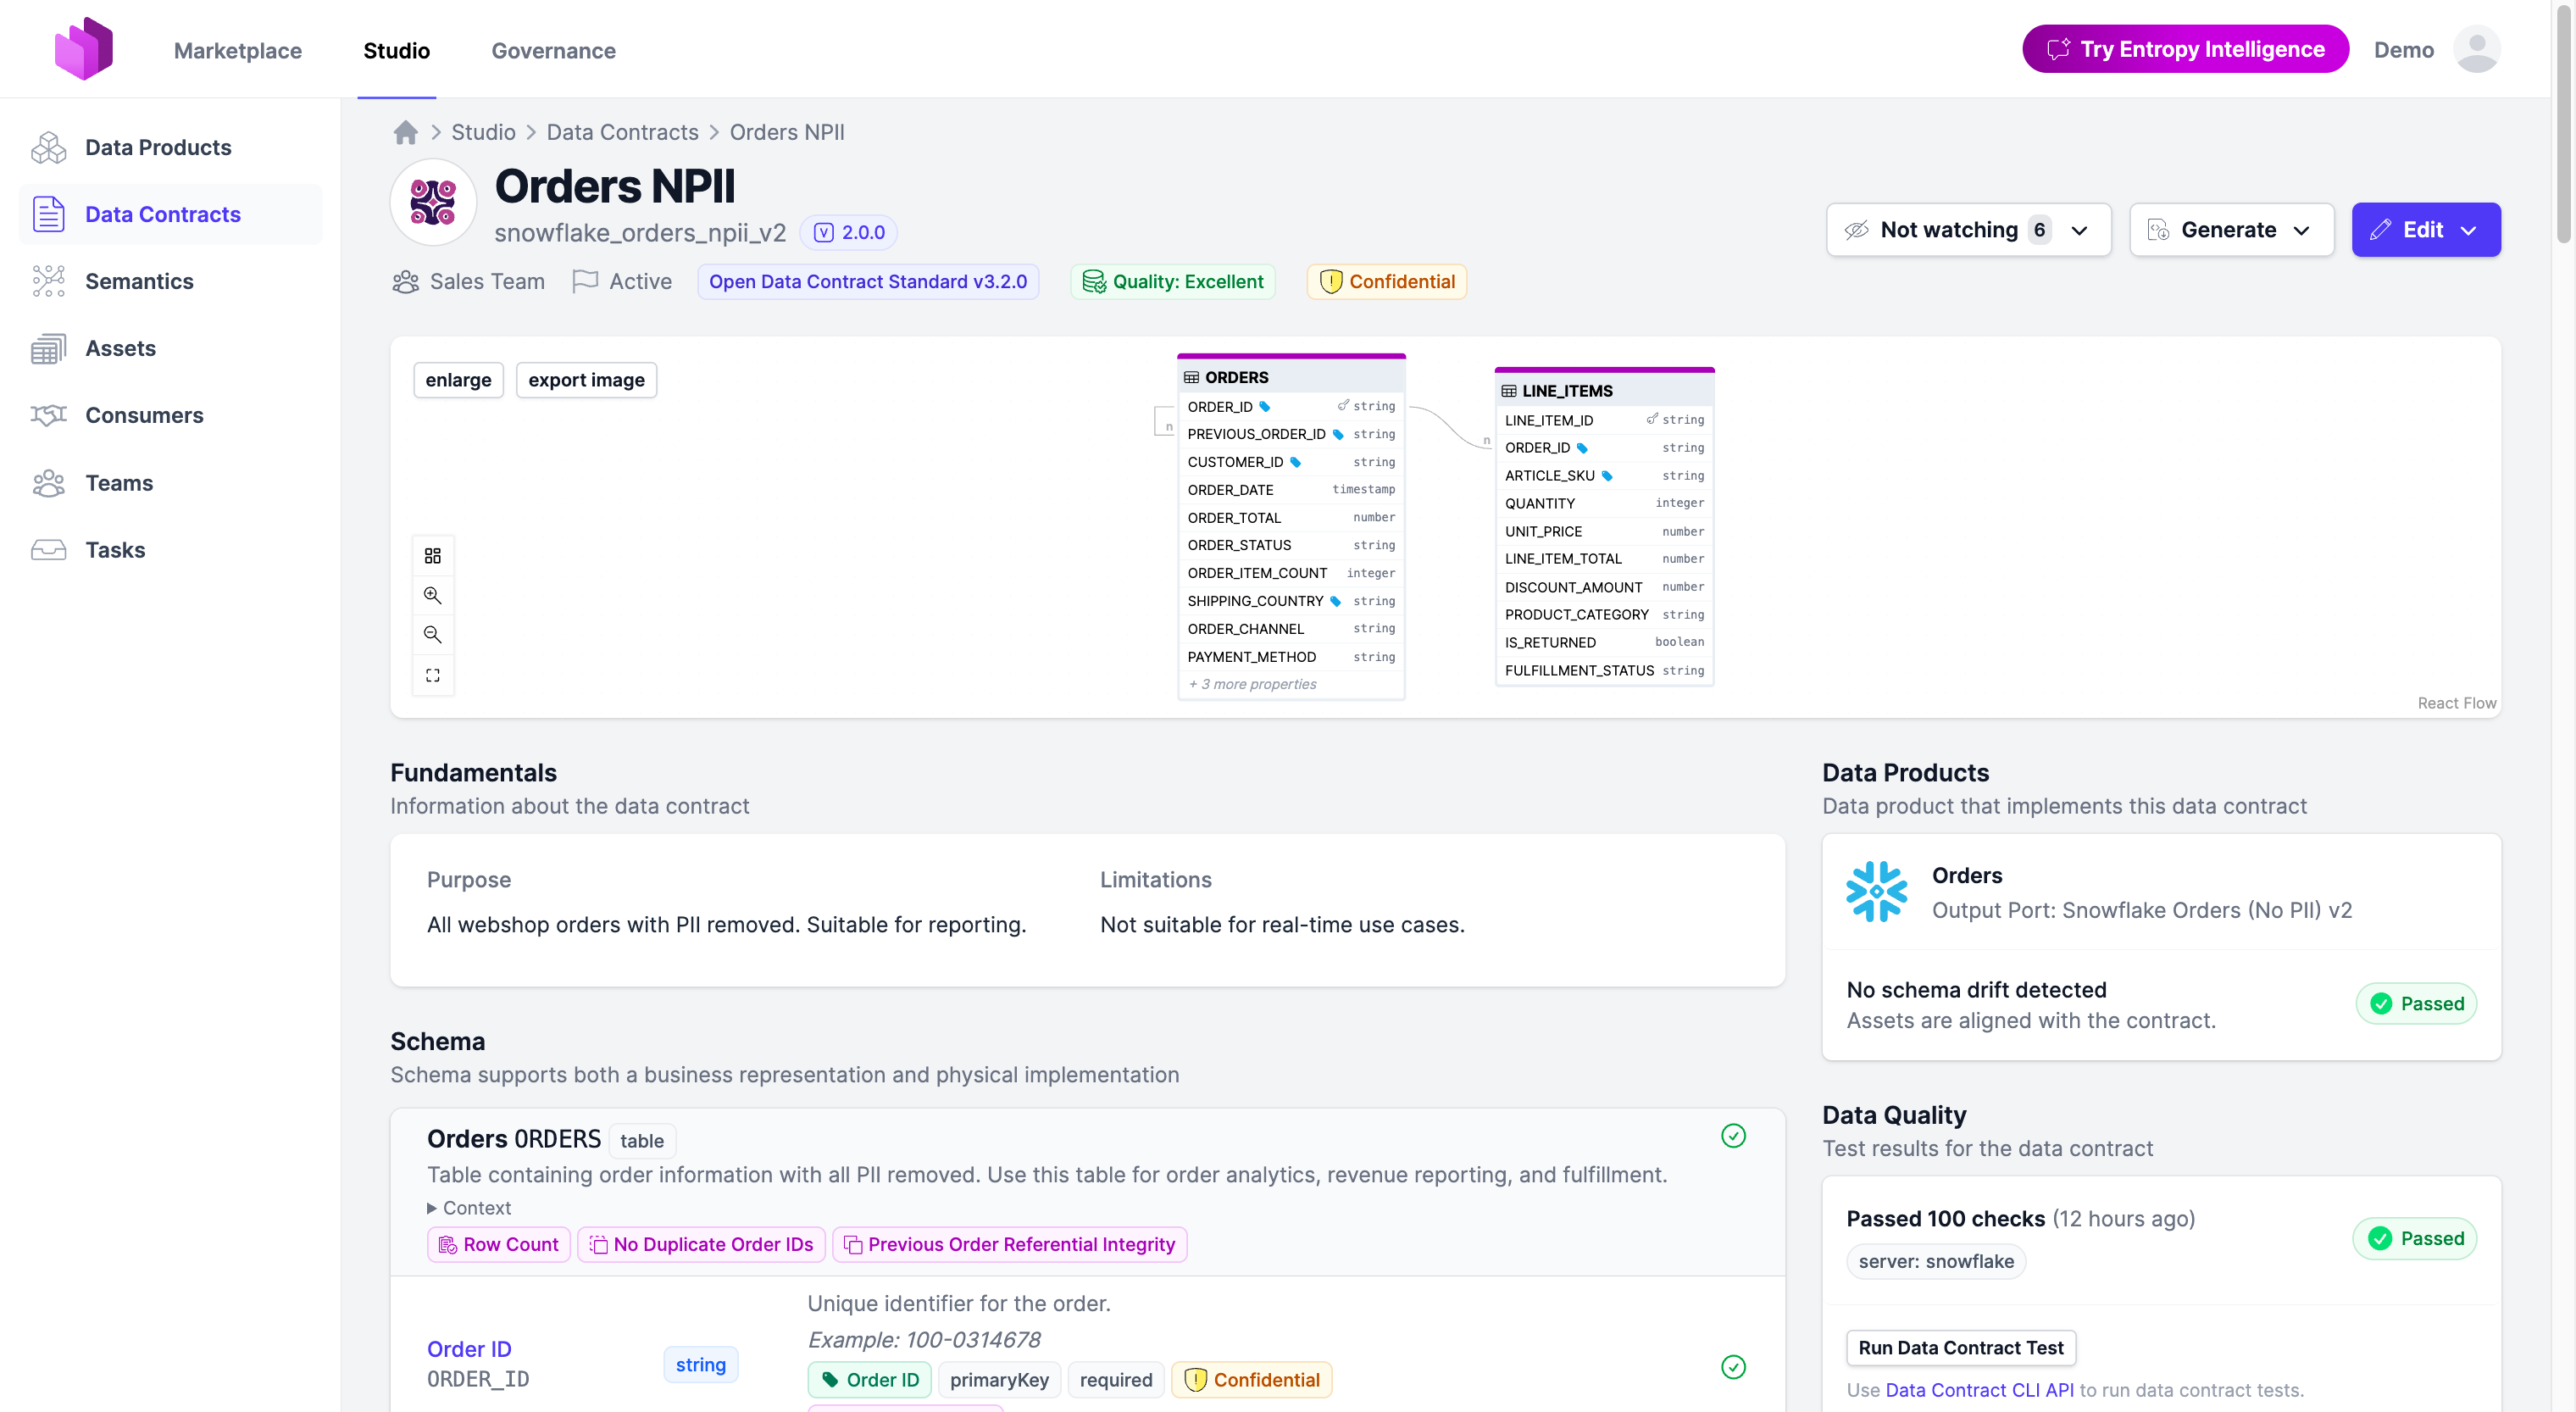
Die zugrunde liegende Semantik wird nicht beliebig vorausgesetzt, sondern kann in Entropy Data Semantics aufgebaut und gepflegt werden. Data Product Owner und Fachexperten modellieren dort unternehmensspezifische Entitäten, Eigenschaften, Metriken und Beziehungen über die Oberfläche oder als YAML. Sie können dabei mit einer eigenen Ontologie beginnen oder bestehende Industrieontologien und RDF-/OWL-Modelle importieren.
Auf dieser Grundlage kann ein Datenprodukt auf zwei Arten modelliert werden. Beim Semantic-first-Ansatz wählt der Owner Entitäten und Attribute aus der in Entropy Data gepflegten Ontologie. Fachliche Definitionen und Klassifikationen werden in den Contract übernommen. Beim Reuse-first-Ansatz greift der Owner auf Tabellen, Felder oder Output Ports vorhandener Data Products zurück und verwendet sie als Inputs für ein neues Produkt.
Der Coding Agent arbeitet mit vier Kontextebenen: Ontologie, Data Contract, Skills und Marketplace. Die Ontologie liefert die fachliche Bedeutung, der Contract beschreibt das gewünschte Produkt und seine Anforderungen, der kundenspezifische Skill kodifiziert die technischen Umsetzungsvorgaben und der Marketplace stellt vorhandene Data Products und Zugriffsmöglichkeiten bereit. Auf dieser Grundlage sucht der Agent geeignete Inputs, beantragt Zugriff, erzeugt beispielsweise eine dbt-Transformationslogik und meldet Lineage und Implementierungsinformationen zurück.
Das fertige Data Product wird veröffentlicht und kann wiederum als Input für weitere Produkte dienen.
Kontrolle und Governance
Policies, Data Product Score, Data-Quality-Tests und Drift Detection begleiten den Lebenszyklus. Qualitätsregeln werden im Contract festgelegt und beispielsweise über die Data Contract CLI in der Zielumgebung ausgeführt. Entropy Data aggregiert und visualisiert die Ergebnisse, besitzt aber keinen eigenen Data Profiler. Breaking Changes werden über neue Output Ports und eine Migrationsphase behandelt.
Interessant ist das zum Patent angemeldete Purpose-Based Access Control. Dabei wird geprüft, ob eine Abfrage zum vereinbarten Verwendungszweck und zu den Bedingungen des Contracts passt. Eine KI-basierte Kontrolle kann eine SQL-Abfrage im Ausführungspfad stoppen und soll auch kritische Ergebnisse erkennen, etwa eine mögliche Re-Identifikation durch zu kleine Ergebnismengen. Der Ansatz ist innovativ, muss seine Zuverlässigkeit, Auditierbarkeit und Skalierbarkeit im produktiven Einsatz aber noch breiter belegen.
Wer sollte sich Entropy Data anschauen?
Der beste Fit sind größere Unternehmen mit mehreren Datenplattformen, die einen unabhängigen Marketplace und eine standardisierte Metadatenschicht suchen. Auch kleinere Teams kommen infrage, wenn sie bereits konsequent mit Data Products und Data Contracts arbeiten.
Voraussetzung sind benannte und kompetente Data Product Owner, ein etabliertes Produktdenken und die Bereitschaft, Contracts und Semantik kontinuierlich zu pflegen. Entropy Data unterstützt die Owner technisch mit standardisierten Modellen, vererbten Definitionen, Policies, Scores, Lineage, Drift Detection und Coding Agents. Das notwendige Operating Model und die fachliche Verantwortung setzt die Lösung – wie bei vielen anderen Lösungen – jedoch voraus. Methodisches Enablement und ein breites Netz erfahrener Implementierungspartner sind bislang weniger stark ausgeprägt.
Meine Einschätzung
Die stärkste Seite von Entropy Data ist die konsequente Verbindung von offenen Standards und Plattformunabhängigkeit. ODCS und ODPS dienen nicht nur dem Import und Export, sondern tragen das Produktmodell. Das ist eine überzeugende Position zwischen proprietären Datenplattformen und individuell entwickelten Lösungen, insbesondere für Unternehmen, die Kontrolle über ihre Metadaten behalten wollen.
Auch die agentische Produkterstellung ist schlüssig. Ontologie, Contract, Skills und Marketplace spannen einen fachlich und technisch beschriebenen Rahmen auf, in dem der Coding Agent die Implementierungsartefakte erzeugt. Das ist mehr als generische Codegenerierung. Besonders relevant finde ich, dass derselbe Kontext zwei Zielgruppen dient: Menschen erhalten verständliche und verlässliche Data Products, während AI Agents die standardisierten und semantisch angereicherten Informationen maschinell verarbeiten können.
Der Ansatz steht und fällt mit den Data Product Ownern. Entropy Data folgt keinem zentralistischen Governance-Modell, sondern stattet dezentrale Verantwortliche mit standardisierten Contracts, vererbten Definitionen und Klassifikationen, Policies, Scores, Lineage, Drift Detection und Coding Agents aus. Das ist konsequent: Verantwortung bleibt dort, wo das fachliche Wissen sitzt, und die technische Unterstützung ist substanziell. Die Lösung nimmt den Ownern Entscheidungen und Verantwortung jedoch nicht ab. Sie müssen Daten, Semantik, Qualitätsregeln, Änderungen und Zugriffe verstehen und die bereitgestellten Funktionen konsequent nutzen. Fehlt diese Kompetenz oder Disziplin, entsteht auch mit guten Oberflächen und AI Agents kein verlässliches Data Product. Die Ontologie ist dabei größter Werthebel und möglicher Engpass zugleich; KI kann ihre Pflege erleichtern, ersetzt aber weder das Operating Model noch die fachliche Abstimmung.
Bei Governance sehe ich noch Entwicklungsbedarf. Viele Kontrollen informieren, bewerten oder benachrichtigen. Policies erzeugen Hinweise und Scores, blockieren aber nicht durchgängig. Mehrstufige Freigaben, verbindliche Gates, Ausnahmen und plattformübergreifendes Enforcement sind noch nicht umfassend ausgeprägt. Für einen jungen Anbieter ist die Konzentration auf Kernfunktionen nachvollziehbar. Wer jedoch über viele Data Products skalieren will, muss Kontrolle automatisieren.
Entropy Data ist deshalb heute klar ein Data Product Marketplace und noch keine umfassende Control Plane. Der Weg dorthin ist erkennbar. Entscheidend wird sein, ob der Anbieter die Governance stärker operationalisiert, weitere Technologiepfade produktisiert und gemeinsam mit Partnern mehr Unterstützung beim Aufbau von Semantik und Skills bereitstellt.
Mein Fazit: Entropy Data ist besonders für Data-Product-erfahrene Unternehmen einen Blick wert, die offene Standards, Plattformunabhängigkeit und Metadatensouveränität priorisieren und über Owner verfügen, die ihre Verantwortung aktiv wahrnehmen können. Die Lösung unterstützt diese Owner mit einer durchdachten Mechanik und einer zukunftsweisenden agentischen Erweiterung, ersetzt aber nicht deren fachliche Kompetenz und Disziplin. Die Vision einer Control Plane ist plausibel. Für ihre Einlösung braucht es neben starken Ownern noch mehr verbindliches Enforcement und belastbare Kundenevidenz.